WORLDGYM: WORLD MODEL AS AN ENVIRONMENT FOR POLICY EVALUATION
Intro
提出一种基于世界模型的策略评估环境(WorldGym),它是一个自回归、以动作为条件的视频生成模型
该世界模型仅需输入单张起始图像帧,单个动作为条件,在推理阶段将扩散模型的预测视界与策略输出的动作块大小对齐,利用视觉‑语言模型(VLM),依据生成视频判断任务是否执行成功。
用于预测 VLA 的好坏,因为VLA算法在真实环境的成功率和世界模型内推演成功率高度相关,策略相对排名被保留。论文实验证明这一点
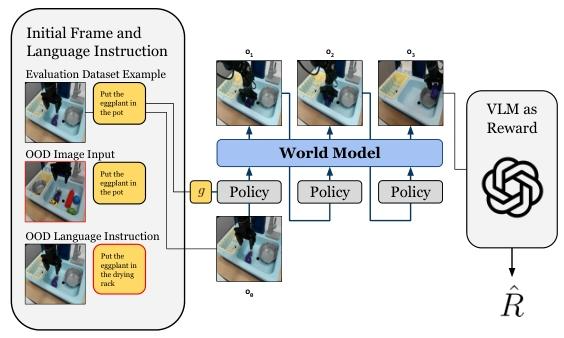
这里的 OOD = out of distribution
可以重点关注:不同构型机器人的策略,对齐预测视界长度与策略的动作块大小,多样化任务与环境数据,分布外测试
模型构建
世界模型
使用 VAE from Stable Diffusion 3
encode 256×256 image frames into latent space
在 Open‑X Embodiment 中 9 套可对齐动作空间的机器人数据集上训练(Bridge V2、RT‑1 等),合计约 100 小时机器人数据;全部使用机器人肩部俯视主摄像头画面。
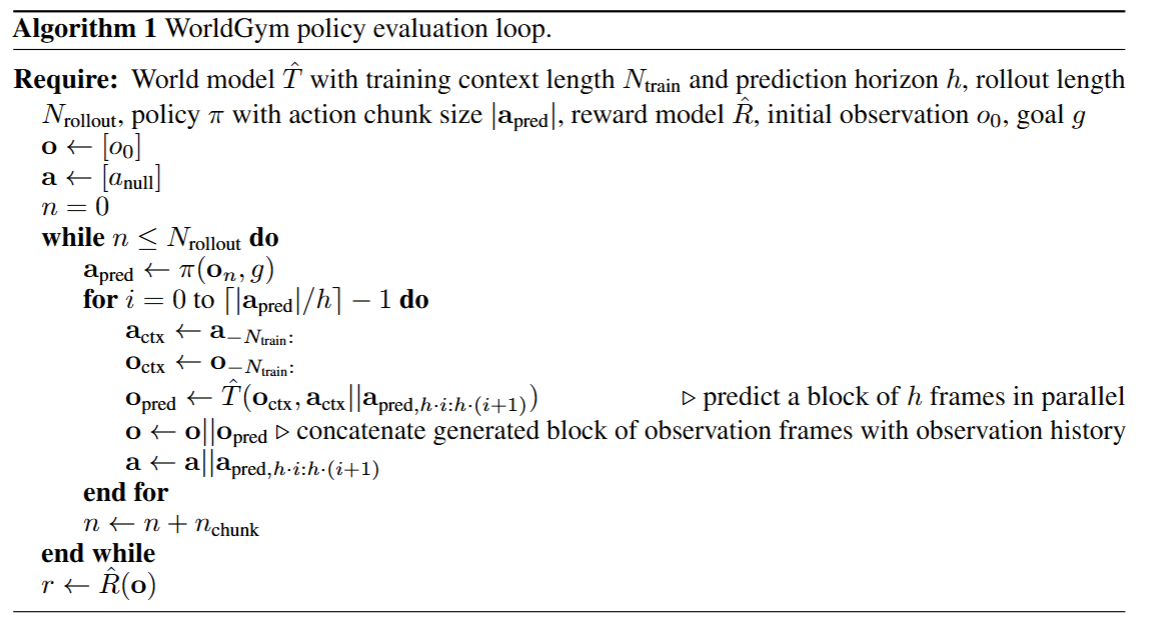
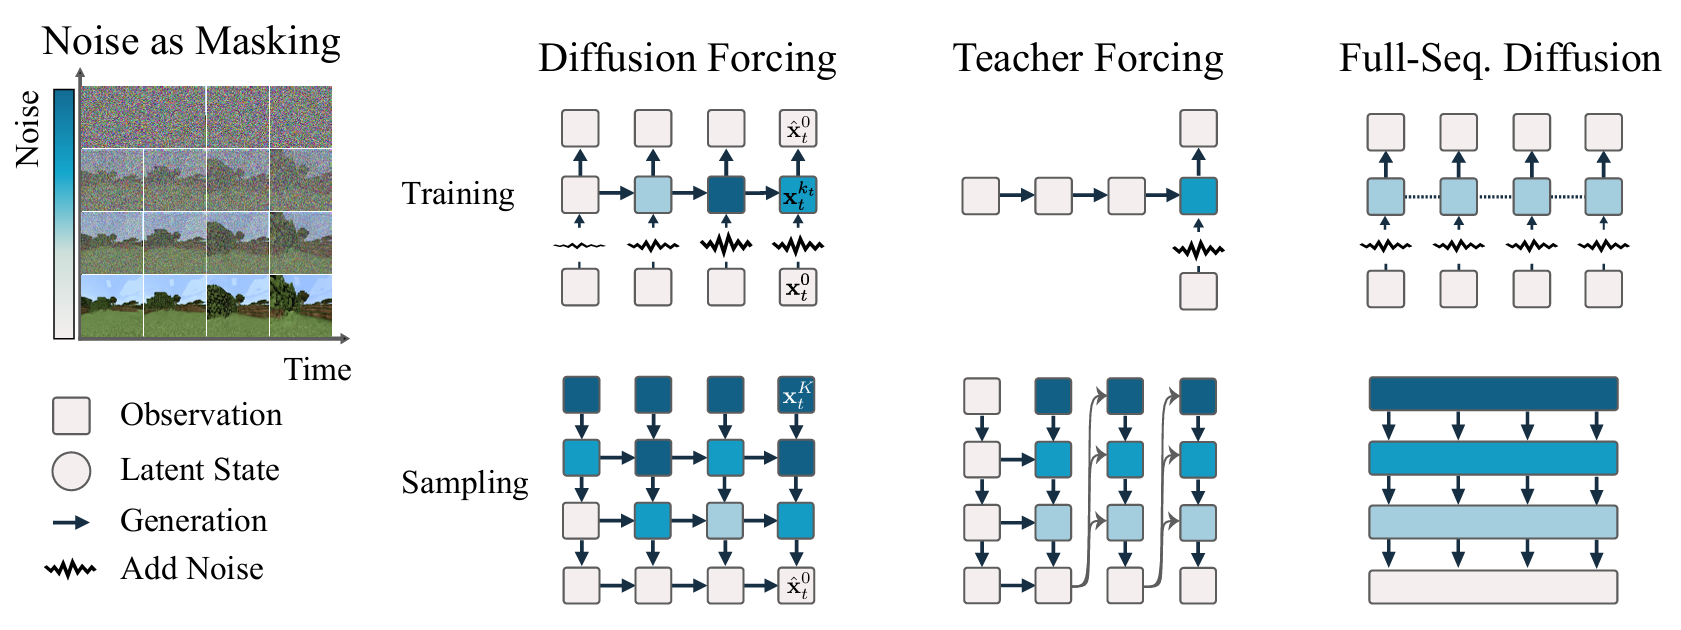
文章采用 Diffusion Forcing 训练方式,使模型能够并行输出动态H帧
Diffusion Forcing
把完整视频一起送进模型。假设一段视频有 16 帧,训练时每一帧单独随机一个噪声强度,所以 16 帧不一定处在同一个 diffusion timestep:有的帧噪声很少,有的帧接近纯噪声。模型的任务还是预测每帧加进去的噪声。
用 causal attention,因此第 帧只能看前面的帧,不能看未来。这样即使训练时整段视频都在输入里,模型也只能根据历史来预测后续画面。
测试时,已观测帧不加噪,作为条件;未来要预测的帧全部从纯噪声开始,再逐步去噪得到视频。想预测更长的视频,就在后面多放几帧纯噪声;这和 LLM 推理时增加待生成 token 的数量有点类似。
奖励模型
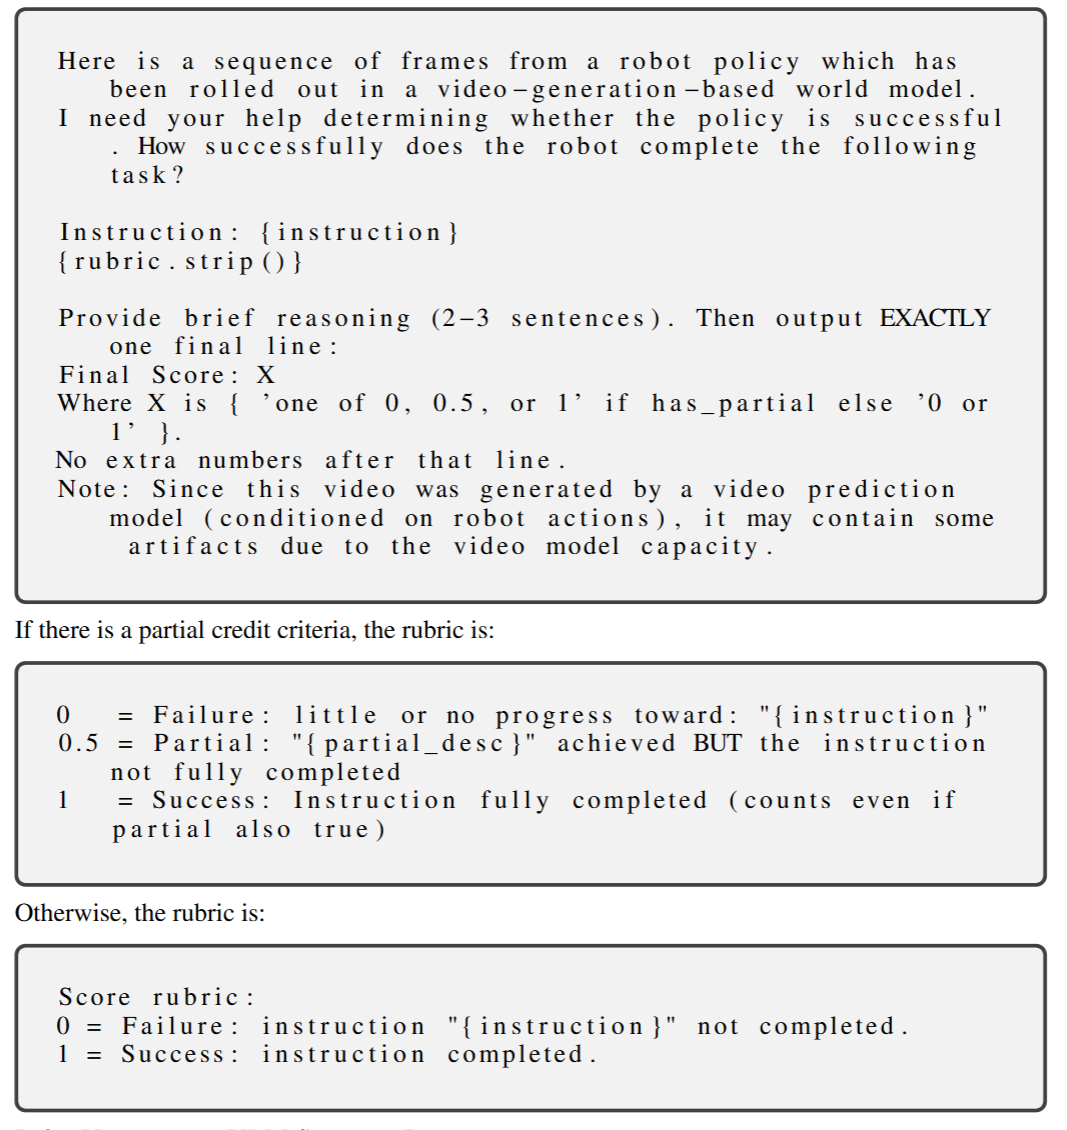
选用 GPT‑4o作为奖励模型,将推演生成的图像帧序列以及语言指令一并输入模型
奖励提示词如下,感觉也是很粗造
接着文章大致定性评估了下这个世界模型的可靠性,但是感觉并不充分,只是给出了几张示意图
在世界模型里评估策略
使用 WorldGym,对三款开源策略开展评估RT‑1‑X(O’Neill 等人,2023)、Octo(Octo 模型团队,2024)以及 OpenVLA(Kim 等人)。
结果表明世界模型给出的性能排序与已知的相对性能保持一致。
- 具有已知性能排序的不同 VLA 策略
- 同一策略的不同版本与模型规模
- 同一策略不同训练步数的检查点 三者都能保持相对性能
Summary
朴素的想法和动机,少启发性